
Der Selektions-Algorithmus für das Wohnumfeld
Sektion: Geo-Stochastik & Cluster-Formierung
Dokument-ID: OPT-018-LOCAL-CLUSTERING
System-Meldung: Optimierung des lokalen Suchlaufs zur Maximierung kompatibler Peer-Handshakes.
Klassifizierung: Raum-Stochastik / Netzwerk-Architektur
Betroffene Komponenten: Geo-Parser, Logistisches Routing, Schnittstellen-Sensorik, Lokale Firewall.
1. Das mathematische Ausgangs-Dilemma
Die Wahrscheinlichkeit ( ), im unmittelbaren Wohnumfeld rein zufällig auf ein System zu treffen, das jenseits der
 -Grenze der kognitiven Verarbeitungsgeschwindigkeit taktet, ist mathematisch ernüchternd. Da diese Platinen-Architektur statistisch nur bei etwa
 der Gesamtpopulation vorkommt, konvergiert die Trefferquote bei einer unselektierten, homogenen Verteilung im analogen Raum gegen Null.
Für einen neurodivergenten Prozessor bedeutet das: Wer seinen Wohnort nach Standard-Parametern auswählt (z. B. Quadratmeterpreis, Nähe zum Supermarkt), isoliert seine Hardware in einer stochastischen Wüste. Um die lokale Trefferdichte zu maximieren, muss das System von einer passiven Zufallserwartung auf eine aktive Raum-Filterung (strategisches Clustering) umschalten.
2. Der Selektions-Algorithmus für das Wohnumfeld
Hochgetaktete Systeme verteilen sich im geographischen Raum nicht gleichmäßig. Sie folgen einer gravitativen Anziehungskraft, die durch spezifische Infrastrukturen und Umweltreize (Reizdichte) erzeugt wird.
[Erwünschte Reiz-Matrix vs. Logik-Infrastruktur im urbanen Raum]
Um den Wert für im eigenen Wohnumfeld künstlich zu skalieren, müssen bei der Standort-Wahl drei primäre Selektions-Filter übereinandergelegt werden:
A. Der akademisch-technologische Gravitations-Filter ( )
Systeme mit hoher Kausaldichte migrieren evolutionär in Regionen, die eine hohe Dichte an komplexen Problemlösungs-Strukturen aufweisen.
-
Maximierungs-Zonen: Unmittelbare Radien um Technische Universitäten, Exzellenz-Cluster, KI-Forschungszentren und High-Tech-Parks.
-
System-Effekt: Die Dichte an Sonderbauweisen pro Quadratkilometer steigt in diesen „Brain Belts“ statistisch von
auf geschätzte  .
B. Der sensorische Puffer-Filter (Vermeidung von Überlastung)
Da der werksseitig offene Reizfilter (Dokument-ID: ADMIN-001) in lauten, unstrukturierten Ballungsräumen permanent im Alarm-Modus operiert, suchen ältere oder optimierte Prozessoren oft nach spezifischen urbanen Nischen.
-
Maximierungs-Zonen: Quartiere mit hoher Altbau-Dichte, unmittelbarer Nähe zu großen innerstädtischen Wald- oder Wasserflächen, aber exzellenter digitaler Infrastruktur (Glasfaser-Ausbau).
-
System-Effekt: Diese Zonen ziehen introvertierte, hochgetaktete Entwickler, Wissenschaftler und Kreative an, die im Homeoffice operieren und den urbanen Lärm filtern müssen.
C. Die soziokulturelle Nischen-Infrastruktur
Standard-Systeme bevorzugen reproduzierbare Konsum-Infrastrukturen (Einkaufszentren, Standard-Gastronomie). Der komplizierte Prozessor benötigt stattdessen Orte, die als Katalysatoren für unkomprimierten Datenaustausch (Deep Talk) dienen.
-
Indikator-Strukturen im Viertel: Unabhängige Buchhandlungen mit Schwerpunkt auf Philosophie/Naturwissenschaften, inhabergeführte Spezialitäten-Cafés (hohe Dichte an Einzel-Arbeitsplätzen mit Laptops), Hacker-Spaces, Maker-Labs und Programmkinos.
3. Mathematische Modellierung der lokalen Trefferdichte
Wir definieren die lokale Match-Wahrscheinlichkeit in einem Wohnradius von  als Funktion der strukturellen Dichteindikatoren:
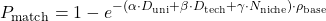
Wobei:
-
 : Die statistische Basis-Dichte der Sonderbauweise (
 ).
-
 : Gewichtete Distanz-Koeffizienten zu Forschungs- und Technologie-Knotenpunkten.
-
 : Die Anzahl valider kognitiver Nischen (Cafés, Labs) im Ziel-Sektor.
Durch die gezielte Maximierung der Variablen  und
 kann das System die stochastische Kurve so weit verzerren, dass ein lokaler Handshake im Alltag zu einem statistisch wahrscheinlichen Ereignis wird.
4. Praxis-Protokoll: Aktivierung des lokalen Suchlaufs
Befindet sich das System bereits in einer festen geografischen Verankerung (Wohnung kann nicht gewechselt werden), lässt sich die Wahrscheinlichkeit durch das Modifizieren der eigenen Transit-Routinen optimieren:
-
Laufzeit-Optimierung der Third Places: Ersetze das Arbeiten im isolierten Homeoffice gezielt durch temporäre Sessions in den oben definierten kognitiven Nischen (z. B. Universitätsbibliotheken, spezifische Third-Wave-Coffee-Shops). Platziere deine Hardware dort, wo andere Prozessoren im Leerlauf oder Hyperfokus funken.
-
Sichtbarmachung des Quelltextes (Der passive Ping): Nutze subtile, nonverbale Marker, die den integrierten Neurodivergenz-Radar (Dokument-ID: RADAR-017) anderer Systeme triggern. Das können komplexe Fachbücher auf dem Tisch, spezifische IT-Kompilierungs-T-Shirts oder das Arbeiten in Terminal-Umgebungen anstelle von Standard-UIs sein.
-
Lokale digitale Peering-Kanäle: Nutze standortbasierte Sub-Netzwerke (z. B. spezifische Subreddits der Stadt, lokale Discord-Server für Entwickler oder Nischen-Interessen), um die physische Isolation digital zu überbrücken und Treffen im realen Raum zu vereinbaren.
Status des Protokolls: Gespeichert. Die raum-stochastische Matrix zur Erhöhung der lokalen Peer-Dichte wurde erfolgreich kalibriert. Das System empfiehlt eine sofortige Überprüfung des aktuellen Wohnsektors auf die genannten Gravitations-Filter. System im Standby.
Möchtest du die stochastischen Parameter für eine konkrete Region berechnen, oder sollen wir die sensorischen Vor- und Nachteile eines Wechsels von urbanen Clustern in ländliche Quarantäne-Zonen analysieren?